GLM-5.3 は画像を読めない。Claude Code が画像入力で止まった話
この記事の概要
先日、Ollama 経由で動かしていた Claude Code のセッションが、エラーで丸ごと止まりました。
作業の途中で、AI が画像ファイルを開いた瞬間です。
それまで普通にコードを読んだりファイルを編集したりしていたのに、画像を扱った途端にエラー。そのセッションでは作業を続けられなくなりました。
原因を調べてみると、かなり単純でした。
普段使っていた glm-5.3:cloud は、そもそも画像入力に対応していませんでした。
そしてさらに情けないことに、この仕様は実際にテストしなくても、Ollama の公式サイトを見れば分かります。
Claude Code では画像も普通に扱える
私は以前の記事で書いたように、Claude Code を Ollama 経由で使っています。
モデルは料金の記事でも触れた glm-5.3:cloud が中心です。
Claude Code の便利なところは、AI が自分でファイルを調べたり、コマンドを実行したりできることです。
「このフォルダを調べて」と言えば中を見てくれるし、コードだけでなくスクリーンショットなどを材料にして作業することもあります。
Anthropic の Claude をそのまま使っている感覚だと、
画像ファイルがあれば、当然 AI が見られるだろう
と思ってしまいます。
ところが、Claude Code の画面が同じでも、裏側で動いているモデルの能力は別です。
今回、そこを完全に見落としていました。
画像入力が失敗した原因は GLM-5.3
最初は、
Claude Code → Ollama の接続部分が画像をうまく渡せていないのでは?
と疑いました。
そこで画像を含むリクエストを直接送るなどして確認しました。
結果として、画像入力が失敗した原因はもっと単純でした。
glm-5.3:cloud 自体がテキストモデルだったからです。
Ollama の公式ページを見ると、glm-5.3:cloud には「Text」と表示されています。
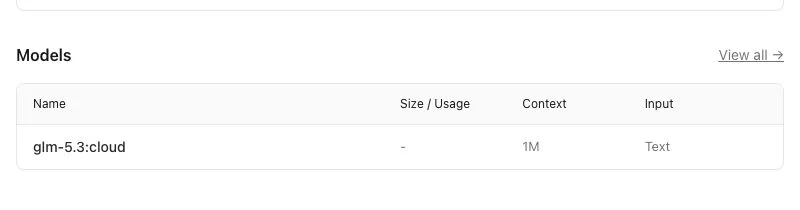
Ollama 公式サイトの glm-5.3:cloud モデル欄。Input は「Text」と表示されている(2026年9月5日時点)。
つまり、
- Claude Code は画像を扱おうとする
- Ollama までリクエストが飛ぶ
- しかし接続先のモデルは画像入力に対応していない
- エラーになる
というだけでした。
Claude Code が何でもできそうに見えるので忘れがちですが、実際に何を処理できるかは接続しているモデル次第です。
しかも公式サイトを見れば分かる
今回いちばんの教訓はここです。
私は原因を調べるため、複数の Ollama Cloud モデルに実際に画像を投げて確認していました。
しかし後から Ollama の公式サイトを見ると、モデル一覧にちゃんと、
- Vision
- Tools
- Thinking
- Cloud
といった属性が表示されていました。
さらに検索画面では、Cloud と Vision を両方指定して絞り込むこともできます。
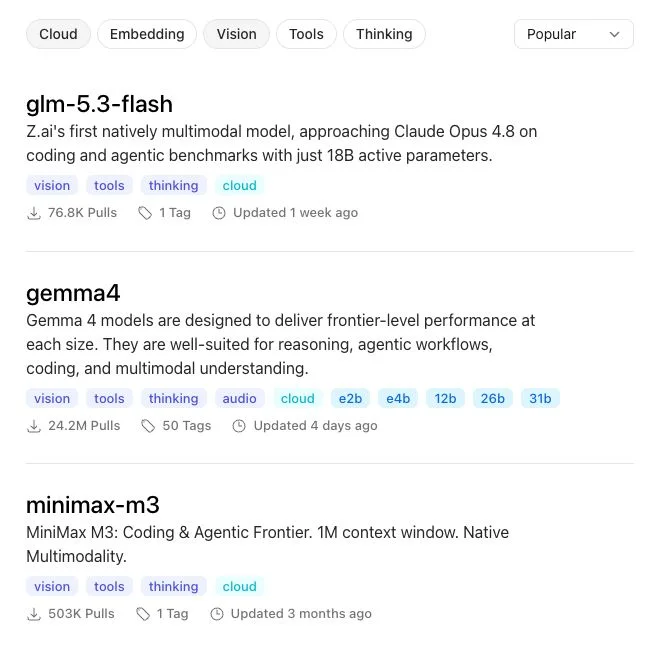
Cloud と Vision で絞り込むと、glm-5.3-flash などの画像対応クラウドモデルが表示される(2026年9月5日時点)。
つまり、画像を扱いたいなら「Cloud + Vision」のモデルを選べばいい。
わざわざ片っ端から画像を送って試す必要はありませんでした。
灯台下暗しです。
GLM-5.3 は Vision 非対応。ただし Ollama Cloud 全体が非対応ではない
ここは重要です。
最初、私は、
Ollama Cloud のモデルって、ほとんど画像を読めないのでは?
と思っていました。
実際、普段プログラミング用途で使っていたモデルを見ると、画像非対応のものが結構あります。
たとえば私が確認した範囲では、次の結果でした。
| モデル | 画像 |
|---|---|
glm-5.3:cloud |
非対応 |
glm-5.2:cloud |
非対応 |
deepseek-v4-flash:cloud |
非対応 |
qwen3.5:cloud |
対応 |
ただし、Ollama Cloud そのものが画像に弱いわけではありません。
公式サイトで Cloud と Vision の両方を指定すると、画像対応モデルがちゃんと出てきます。
2026年9月5日時点では、たとえば次のモデルが Vision 対応として掲載されています。
glm-5.3-flashqwen3.5gemma4minimax-m3- Kimi 系の一部
つまり正確には、
Ollama Cloud のモデルが画像を読めない
ではなく、
Ollama Cloud で使えるモデルには、画像対応とテキスト専用が混在している
です。
そして私がメインで使っていた glm-5.3 は後者でした。
GLM-5.3 Flash という選択肢もある
さらに調べると、同じ GLM 系でも glm-5.3-flash は Vision 対応です。
これはかなり面白いところです。
通常の glm-5.3 は、
- Tools
- Thinking
- Cloud
ですが、glm-5.3-flash は、
- Vision
- Tools
- Thinking
- Cloud
となっています。
つまり、Claude Code で画像も扱いたい場合、GLM 系を使い続けながら Vision 対応モデルへ切り替えるという選択肢もあります。
単純に「画像なら Qwen3.5」という話でもありませんでした。
Claude Code ではこの違いが事故につながる
普通のチャット AI なら、
このモデルは画像を読めません
で終わる話です。
しかし Claude Code のようなエージェント型ツールでは、少し事情が違います。
Claude Code は自分でファイルを探索します。
そのため、ユーザー自身が画像を添付していなくても、作業ディレクトリの中に画像があり、AI が「これも確認した方がよさそうだ」と判断して開こうとする可能性があります。
そこで接続先がテキスト専用モデルだと、今回のようなエラーが発生します。
つまり、自分が画像を使うつもりがなくても、エージェント側が画像を触る可能性がある。
ここが普通の LLM 利用との違いです。
対処方法
今のところ、対処方法は大きく3つありそうです。
1. Vision 対応モデルを使う
一番素直です。
Ollama 公式サイトで Cloud + Vision に絞り込んで、その中から Claude Code 向きのモデルを選びます。
たとえば qwen3.5:cloud や、GLM を使いたいなら glm-5.3-flash:cloud が候補になります。
2. 画像を使う作業だけモデルを変更する
普段はコーディング性能を優先して glm-5.3:cloud を使い、画像が必要なときだけ Vision モデルに切り替える方法です。
常にマルチモーダルモデルを使う必要がないなら、この運用でも十分です。
3. Claude Code に画像を開かせない
もう一つは、AI への指示で画像ファイルを直接読まないようにする方法です。
画像の内容が必要なら OCR などを使って先にテキスト化し、その結果だけ LLM へ渡します。
画像を見る必要がないコーディング作業なら、これが一番事故は少なそうです。
モデルを選ぶときは「入力形式」も確認する
これまで外部モデルを選ぶときは、
- コーディング性能
- 推論性能
- 速度
- コンテキスト長
- 料金
あたりを中心に見ていました。
でも Claude Code のようなエージェントで使うなら、Vision に対応しているかも確認した方がいいです。
そしてこれはベンチマークを調べたり、モデルを実際に動かしたりしなくても、Ollama なら公式のモデル一覧で確認できます。
今回私はそこを見ずに、
Claude Code なんだから画像くらい見られるだろう
と勝手に思い込んでいました。
Claude Code は同じでも、その後ろに何をつないでいるかによって能力は変わります。
外部モデルを Claude Code につなぐなら、モデルの賢さを見る前に「Text / Vision / Tools」の対応状況を確認する。
今後はこれをチェックしてからモデルを差し替えようと思います。
少なくとも、セッションが止まってから気づくよりはずっと安上がりです。